
Як перевірити доступ ШІ-краулерів до сайту: robots.txt, файрвол і журнали сервера
 Євген Павленко
Коротка відповідь. Доступ перевіряють у чотири шари: robots.txt для кожного бота окремо, правила CDN і файрвола, журнали сервера і звірка IP з офіційними списками платформ. Самого robots.txt мало. На 9 із 39 великих українських сайтів, які ми перевірили 12 листопада 2026 року, файл дозволяв ClaudeBot, проте сервер на це ім’я відповідав 403, 429, 503 або зовсім не відповідав.
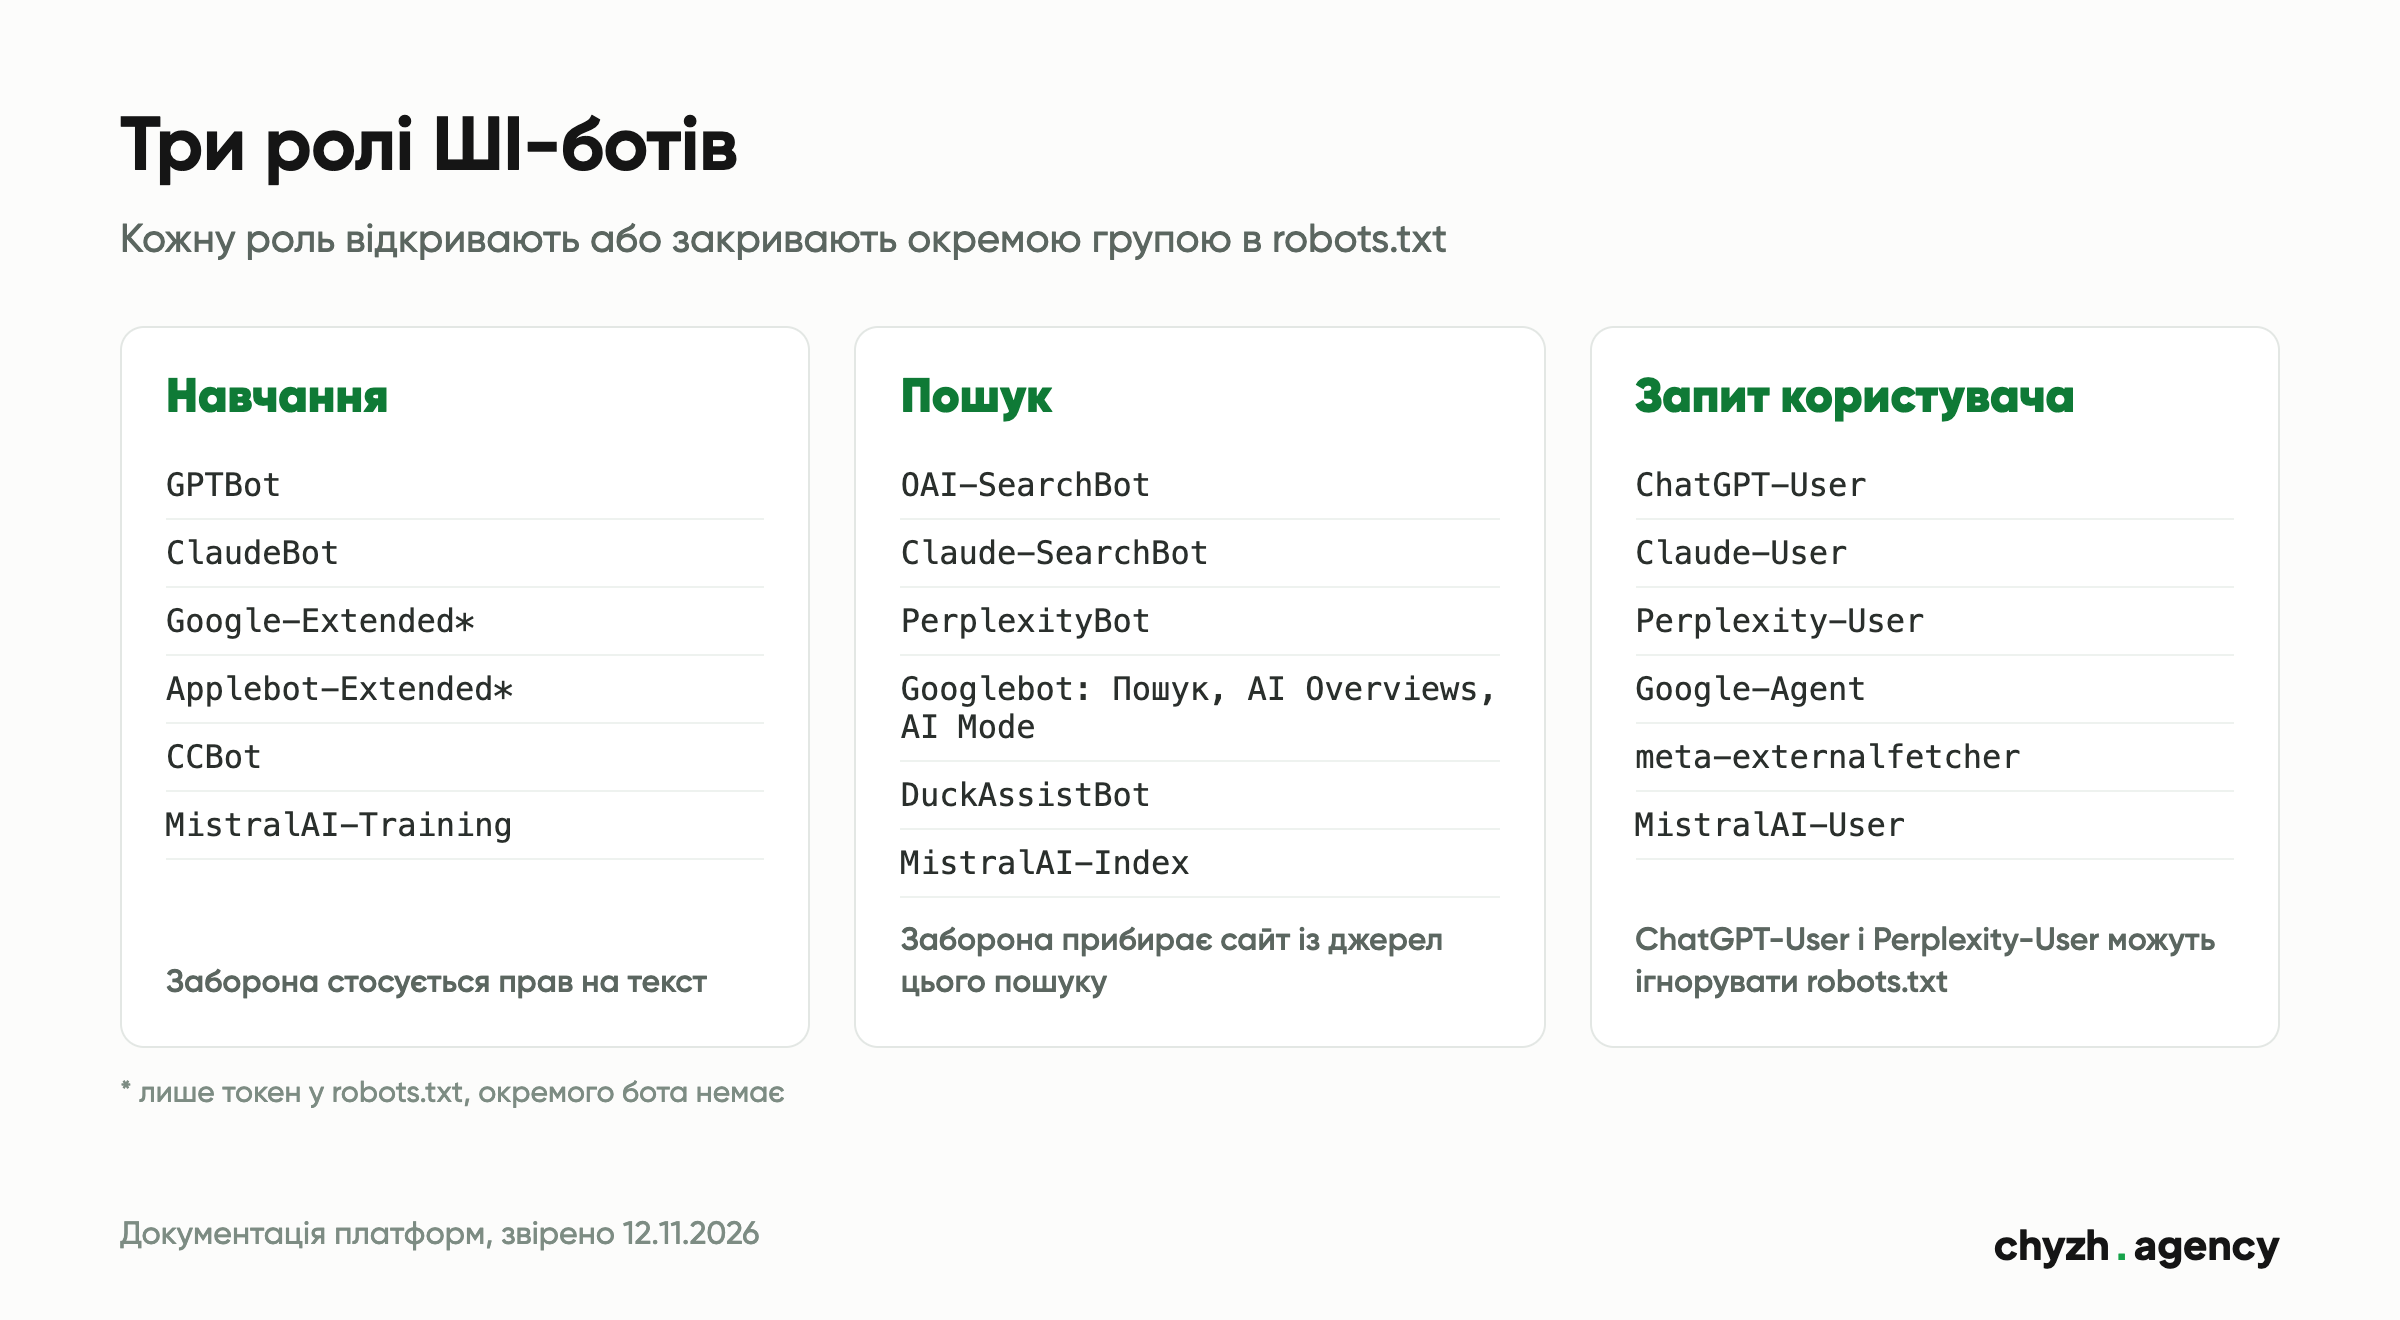
Кого пускати, залежить від мети. Від пошукових ботів і ботів запиту користувача залежить, чи зможе ШІ-система відкрити й процитувати сторінку. Боти для навчання стосуються прав на текст.
Нижче матриця ботів за платформами, що показали 30 днів журналів нашого сайту chyzh.agency, і шість кроків перевірки.
Три ролі ШІ-ботів: навчання, пошук і запит користувача
Платформи розводять ботів за задачами, тож кожну роль відкривають чи закривають окремим рядком у robots.txt.
- Навчання. Бот збирає сторінки, які можуть потрапити в навчання моделей: GPTBot в OpenAI, ClaudeBot в Anthropic, meta-externalagent у Meta. Google і Apple мають для цього лише токени без окремого бота: Google-Extended і Applebot-Extended.
- Пошук. Бот будує індекс, з якого ШІ-пошук бере джерела з посиланнями: OAI-SearchBot для ChatGPT, Claude-SearchBot, PerplexityBot. OpenAI пише прямо: сайти, закриті для OAI-SearchBot, не з’являються у відповідях пошуку ChatGPT, хіба що як навігаційні посилання.
- Запит користувача. Бот відкриває конкретну сторінку, коли про неї питає людина в чаті: ChatGPT-User, Claude-User, Perplexity-User. OpenAI і Perplexity попереджають, що такі запити можуть не виконувати robots.txt. Anthropic пише, що всі три її боти robots.txt виконують.
Найбільше плутанини навколо Google. За документацією Google (оновлена 30.10.2026), Google-Extended керує навчанням Gemini і підстановкою даних з індексу в Gemini Apps і Vertex AI (grounding). На появу сайту в Пошуку він не впливає. Щоб потрапити посиланням в AI Overviews чи AI Mode, сторінка має бути в індексі Пошуку і мати право на сніпет, а керувати цим Google пропонує через правила для Googlebot і директиви nosnippet, max-snippet, noindex. Закрити Googlebot заради цього означає зникнути з Пошуку.
Матриця ботів за платформами
Звірено з вихідним HTML офіційних сторінок 12.11.2026, дати оновлення в джерелах наприкінці.
| Платформа | Бот | Роль | robots.txt за документацією | Перевірка IP |
|---|---|---|---|---|
| OpenAI | GPTBot | навчання | виконує | gptbot.json |
| OpenAI | OAI-SearchBot | пошук ChatGPT | виконує, зміни підхоплює приблизно за 24 год | searchbot.json |
| OpenAI | ChatGPT-User | запит користувача | правила «можуть не застосовуватися» | chatgpt-user.json |
| Anthropic | ClaudeBot | навчання | виконує, підтримує Crawl-delay | bots.json |
| Anthropic | Claude-SearchBot | пошук Claude | виконує | той самий список |
| Anthropic | Claude-User | запит користувача | виконує | той самий список |
| Perplexity | PerplexityBot | пошук, за документацією без навчання | виконує, до 24 год | perplexitybot.json |
| Perplexity | Perplexity-User | запит користувача | «зазвичай ігнорує» | perplexity-user.json |
| Googlebot | Пошук, зокрема AI Overviews і AI Mode | виконує | common-crawlers.json, DNS *.googlebot.com | |
| Google-Extended | навчання Gemini і grounding | лише токен, окремого бота немає | не потрібна | |
| Google-Agent | агенти Google на запит користувача | зазвичай ігнорує | user-triggered-agents.json | |
| Apple | Applebot | Siri, Spotlight, Safari; дані можуть піти в навчання | виконує; без своєї групи бере правила Googlebot | applebot.json, DNS *.applebot.apple.com |
| Apple | Applebot-Extended | заборона навчання моделей Apple | лише токен, сам не сканує | не потрібна |
| Meta | meta-externalagent | навчання й індексація | виконує | списку немає |
| Meta | meta-webindexer | пошук Meta AI | виконує | списку немає |
| Meta | meta-externalfetcher | запит користувача | може обходити | списку немає |
| Amazon | Amazonbot · Amzn-SearchBot · Amzn-User | сервіси й навчання · пошук Alexa · запит користувача | виконують; Amzn-User може виконувати не всі правила | списки на сторінці Amazon |
| Mistral | MistralAI-Training · MistralAI-Index · MistralAI-User | навчання · пошук у Vibe · запит користувача | окремий токен для кожної ролі | списки для Index і User |
| DuckDuckGo | DuckAssistBot | відповіді DuckAssist, без навчання | виконує, зміни за 72 год | duckassistbot.json |
| Common Crawl | CCBot | відкритий архів вебу | виконує | ccbot.json, DNS *.crawl.commoncrawl.org |
Дві деталі, на яких часто помиляються. Перша: група для конкретного бота і загальна група * не поєднуються. Бот, названий у власній групі, правил із * уже не читає. Друга: Applebot без власної групи виконує правила, написані для Googlebot.
Що показали 30 днів журналів chyzh.agency
Як рахували. Взяли журнали nginx нашого сайту за 13.10–11.11.2026 (час UTC). У нашій конфігурації журнал записує справжні адреси клієнтів. Кожен запит з іменем бота звірили з офіційним списком IP платформи станом на 12.11.2026. Окремо виділили сканер: адреси, які за місяць назвалися трьома й більше різними ШІ-ботами або шукали файли .env, ключі й паролі.
| Бот | Запитів з цим ім’ям | З офіційних IP | Сканер під чужим ім’ям | Інші IP поза списком |
|---|---|---|---|---|
| GPTBot | 2 335 | 2 248 | 87 | 0 |
| ClaudeBot | 1 833 | 1 752 | 81 | 0 |
| PerplexityBot | 930 | 833 | 97 | 0 |
| OAI-SearchBot | 371 | 272 | 99 | 0 |
| ChatGPT-User | 337 | 195 | 109 | 33 |
| Claude-User | 184 | 26 | 71 | 87 |
| Claude-SearchBot | 76 | 0 | 76 | 0 |
| Perplexity-User | 67 | 0 | 67 | 0 |
| Googlebot, для порівняння | 2 510 | 2 100 | 177 | 233 |
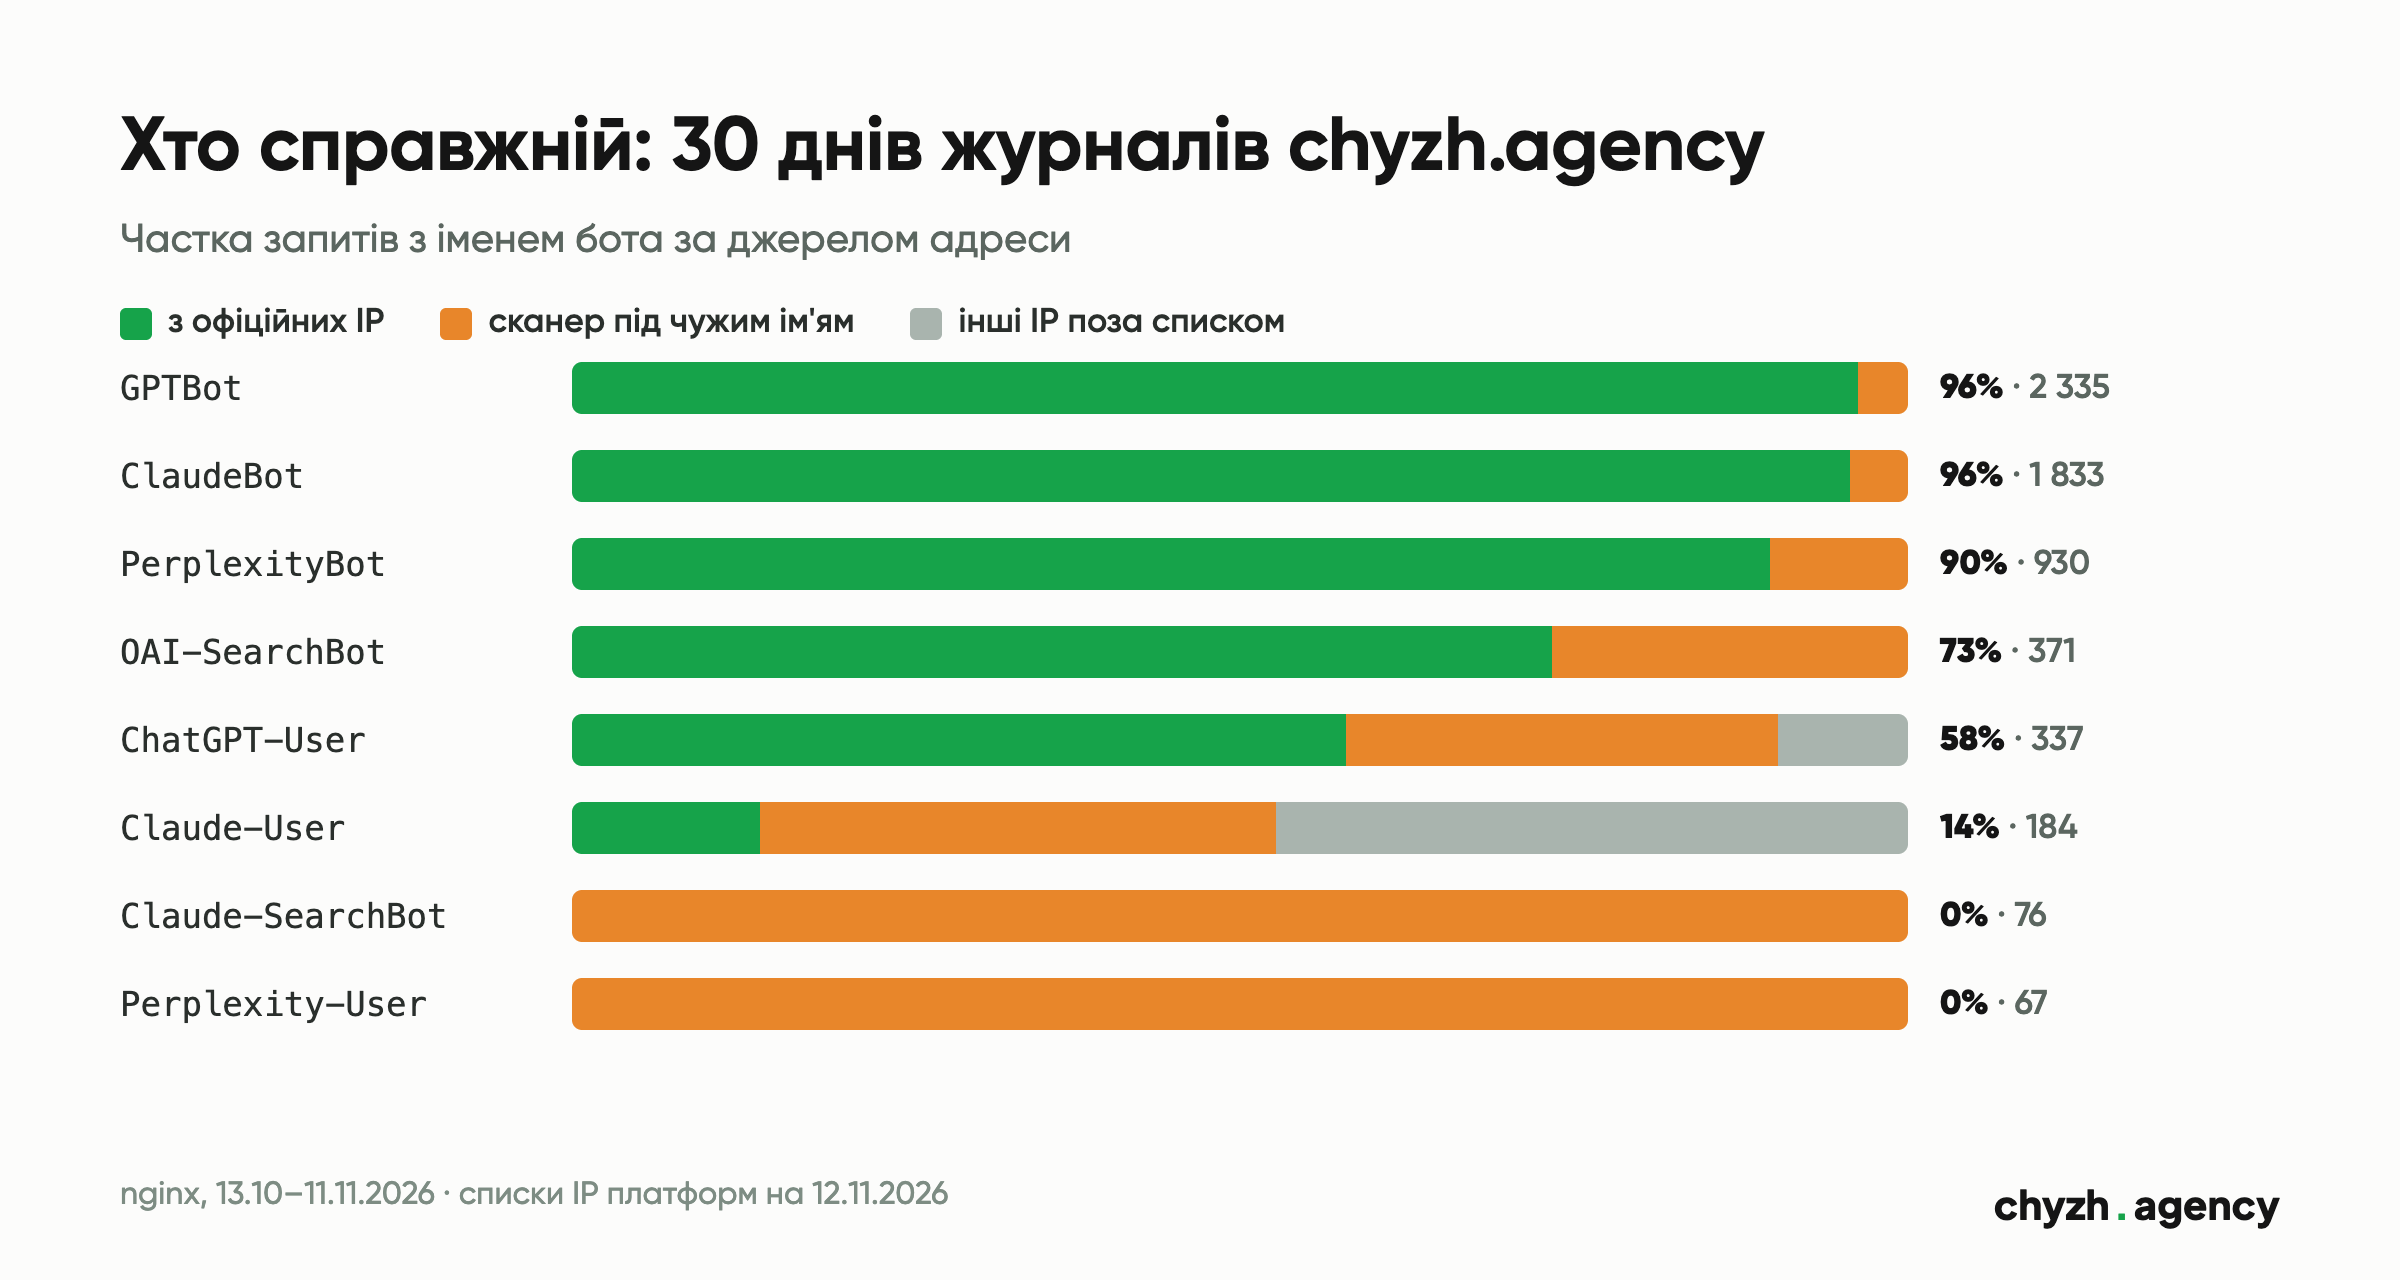
Імена ШІ-ботів використовує сканер. Таких адрес 38. З них 24 по черзі називали себе трьома й більше ботами, 34 шукали .env, ключі хмарних сервісів і SSH. 20 адрес належать Google Cloud, 13 Cloudflare. Claude-SearchBot і Perplexity-User за 30 днів приходили лише від сканера, справжніх візитів цих ботів у журналі немає. Загалом із 6 301 запиту з іменами ботів OpenAI, Anthropic, Perplexity і DuckDuckGo 964 (15,3%) прийшли не з адрес цих платформ.
Перевірених запитів від ШІ-ботів більше, ніж від Googlebot. Боти OpenAI, Anthropic і Perplexity зробили 5 326 запитів з офіційних адрес, Googlebot 2 100, у 2,5 раза менше. Скільки з цих візитів закінчилися цитуванням, журнал не показує.
GPTBot читає переважно карти сайту. На sitemap-файли припало 77% його перевірених запитів, на сторінки й записи 13%. 901 запит пішов на /ru/sitemap_index.xml, якої не існує, тобто отримав 404. З 16.10 по 06.11 це повторювалося приблизно 40 разів на добу. Адресу називає службовий /ru/robots.txt, який WordPress із Yoast генерує для мовної версії. На сторінках сайту й у головній карті сайту її немає. Помилку ми знайшли саме під час цього розбору і 12.11.2026 виправили: /ru/robots.txt, /ua/robots.txt і карти сайту в мовних каталогах тепер переадресовують (301) на кореневі файли.
Запити користувачів видно в журналі. ChatGPT-User прийшов 195 разів із 164 різних адрес OpenAI, усі з відповіддю 200: головна 86, сторінки й записи 80, кейси 25. Claude-User з адрес зі списку Anthropic прийшов лише 26 разів. Ще 87 запитів із цим ім’ям надійшли з адрес поза списком, майже половина цих адрес у Google Cloud. Чи це Anthropic з нових адрес, чи підробка, з наших даних сказати не можна.
Чи читають боти robots.txt, з журналу не видно. Типовий шаблон nginx на нашому сервері вимикає запис для /robots.txt рядком access_log off. Якщо хочете бачити, коли боти перечитують правила, перевірте цей рядок у своїй конфігурації.
Межі цих даних. Один сайт агенції за 30 днів. Списки IP ми взяли станом на 12.11.2026, а платформи їх оновлюють: OpenAI оновила список ChatGPT-User 06.11, Perplexity свої 28.10, Anthropic 20.10. Тож частина «інших IP поза списком» може бути справжньою. Bytespider і боти Meta офіційних списків IP не мають, їх ми не звіряли.
Що закривають великі українські сайти
Як рахували. 12.11.2026 ми завантажили robots.txt 55 великих публічних сайтів: 16 інтернет-магазинів, 10 маркетплейсів і дощок оголошень, 16 медіа, 8 банків, 5 операторів зв’язку й доставки. Файли розібрали за тими самими правилами, що й наш чекер. Потім тричі запросили головну сторінку кожного сайту з підписом браузера і з підписами п’яти ШІ-ботів.
- 47 файлів прочиталися. 8 сайтів замість robots.txt віддали HTML-сторінку з помилкою, перевіркою або заглушкою, 4 з них сторінку перевірки Cloudflare.
- Жоден із 47 файлів не закриває весь сайт для GPTBot, ClaudeBot, OAI-SearchBot, PerplexityBot чи ChatGPT-User. 5 сайтів закривають інших ботів: Amazonbot (3), CCBot, Bytespider і meta-externalagent (по одному).
- 13 сайтів називають ШІ-ботів поіменно. На 4 з них бот отримує власну групу лише з
Allow: /і через це не бачить від 3 до 47 заборон із групи*: пошуку, особистого кабінету, кошика. - 33 з 55 сайтів працюють через Cloudflare, судячи із заголовка Server.
- 16 сайтів відповіли 403 або 503 навіть на запит із підписом браузера, тож файрвол реагує на наш клієнт, і порівнювати там нічого. З решти 39 сайтів 9 у всіх трьох прогонах відповідали на ім’я ШІ-бота інакше, ніж браузеру: 403, 429, 503 або тиша. ClaudeBot отримав відмову на всіх 9, GPTBot і PerplexityBot на 4. Robots.txt на всіх 9 цього бота дозволяє, на двох навіть окремою групою.
Межі цих даних. Ми підставляли лише ім’я бота з нашої адреси. Файрвол може пропускати справжнього ClaudeBot з адрес Anthropic і відсікати тих, хто лише назвався ним, як сканер у наших журналах. Як сайт відповідає справжнім ботам, видно тільки в його журналах і панелі CDN.
Перевірка доступу за шість кроків
-
Прочитайте robots.txt очима бота. Для кожного потрібного бота знайдіть його групу. Немає групи, діє
*. Є група, бот читає лише її. Піддомени мають власні robots.txt. Код відповіді теж має значення: на 4xx (крім 429) Google вважає, що обмежень немає, а на 5xx перші 12 годин зупиняє сканування сайту. -
Пропустіть домен через чекер. Наш чекер ШІ-краулерів розбирає robots.txt для 23 ботів, групує їх за ролями і показує рядок, який спрацював. Правил файрвола він не бачить, тому вердикт звучить як «дозволено robots.txt».
-
Перевірте CDN і файрвол. У Cloudflare це Security → Settings → Bot traffic → AI Crawler and Agent access policies. Для пошуку, агентів і навчання окремо обирають Block, Block on pages with ads або Allow, а для навчання ще Disallow через robots.txt. Якщо ввімкнено Bot Preference Sync і хоч одна політика блокує, Cloudflare дописує свої заборони на початок вашого robots.txt. Bot Fight Mode винятками у WAF не обійти. Типові значення змінювалися: у липні 2025 року Cloudflare оголосила блокування ШІ-краулерів за замовчуванням, а чинна документація (оновлена 02.11.2026) ставить новим доменам Allow. Дивіться налаштування своєї зони.
-
Запитайте сторінку від імені бота. Порівняйте код відповіді для браузера й для бота:
curl -s -o /dev/null -w "%{http_code}\n" -A "Mozilla/5.0" https://example.com/
curl -s -o /dev/null -w "%{http_code}\n" -A "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; ClaudeBot/1.0; +claudebot@anthropic.com)" https://example.com/
Різні коди означають, що сервер реагує на ім’я. Чи пропустить він справжнього бота з його адреси, цей тест не покаже.
-
Подивіться журнали. Порахуйте запити й коди відповіді за кожним ботом, наприклад для ClaudeBot:
grep "ClaudeBot" access.log | awk '{print $9}' | sort | uniq -cОкремо перевірте, чи сервер узагалі записує запити до
/robots.txt. -
Звірте IP. Адреси з журналу порівняйте зі списками з таблиці вище. Google, Apple і Common Crawl додатково дають перевірку через зворотний і прямий DNS, приклад із документації Google:
host 66.249.66.1
host crawl-66-249-66-1.googlebot.com
Запити, які звірку не пройшли, не рахуйте візитами ботів і не відкривайте для них файрвол.
Кого пускати, а кого закривати
Для сайту послуг чи магазину, якому потрібні звернення з ШІ-пошуку, ми лишаємо відкритими пошукових ботів і ботів запиту користувача. Ботів для навчання закривають, коли важливо, щоб тексти не потрапляли в моделі, наприклад у медіа з платним доступом. За документацією OpenAI, Anthropic, Google і Apple, на появу в їхньому пошуку це не впливає.
З’являються й загальні сигнали «без навчання». Anthropic з 30.10.2026 почала поступово враховувати машиночитаний сигнал за чернеткою робочої групи IETF aipref, проте правило для ClaudeBot у robots.txt має вищий пріоритет. Google планує підтримати цей сигнал на початку 2027 року.
Відкритий доступ цитування не гарантує, він лише дає платформі прочитати сторінку. Що перевіряти далі, ми описали в статті що таке GEO-аудит. Якщо сторінки немає навіть у звичайному індексі, почніть із розбору чому сторінка не індексується.
Наступний крок
Пройдіть шість кроків для головної і для двох-трьох сторінок, з яких приходять заявки, і запишіть, які боти до них реально дістаються. Якщо журнали, файрвол і robots.txt показують різне, почніть із файрвола: він відповідає ботові раніше, ніж той дістанеться до robots.txt чи сторінки. Доступ ботів, журнали й налаштування CDN ми перевіряємо на старті GEO-просування.
Автор: Євген Павленко, DevOps. Перевірив: Дмитро Попрядухін, Head of SEO.
Джерела: OpenAI, «Overview of OpenAI Crawlers», дати оновлення на сторінці немає, звірено 12.11.2026; списки IP OpenAI gptbot.json (22.09.2026), searchbot.json (02.01.2026), chatgpt-user.json (06.11.2026); Anthropic, «Does Anthropic crawl data from the web, and how can site owners block the crawler?», оновлено 04.11.2026, список IP bots.json (20.10.2026); Perplexity, «Perplexity Crawlers», оновлено 29.10.2026, списки IP 28.10.2026; Google, «List of Google’s common crawlers», 30.10.2026; «List of Google user-triggered fetchers», 19.08.2026; «Verify requests from Google crawlers and fetchers», 20.03.2026; «AI features and your website», 10.12.2025; «How Google interprets the robots.txt specification», 23.10.2026; Apple, «About Applebot», 04.09.2026; Meta, «Meta Web Crawlers», 21.05.2026; Amazon, «Amazon Web Search crawlers», 26.10.2026; Mistral, «Mistral crawlers», без дати, звірено 12.11.2026; DuckDuckGo, сторінка про DuckAssistBot, без дати, звірено 12.11.2026; Common Crawl, «CCBot», без дати, список IP 11.08.2026; Cloudflare, «AI Crawler and Agent access policies» і «robots.txt setting», 02.11.2026, «Bot Fight Mode», 03.08.2026, блог «Content Independence Day», 01.07.2025; журнали nginx chyzh.agency за 13.10–11.11.2026; robots.txt і відповіді головних сторінок 55 українських сайтів, 12.11.2026; знімок видачі Google Україна за запитом «як перевірити доступ ai краулерів до сайту», 12.11.2026.
Схожі статті
Прогнали безкоштовні перевірки audit.chyzh.agency на своєму сайті: бали від 0 до 100. Що бачить автомат,...
Навіть ШІ-режим Google плутає GEO з локальним SEO. Що входить у GEO-просування сайту, які поради...