
Как проверить доступ ИИ-краулеров к сайту: robots.txt, файрвол и журналы сервера
 Евгений Павленко
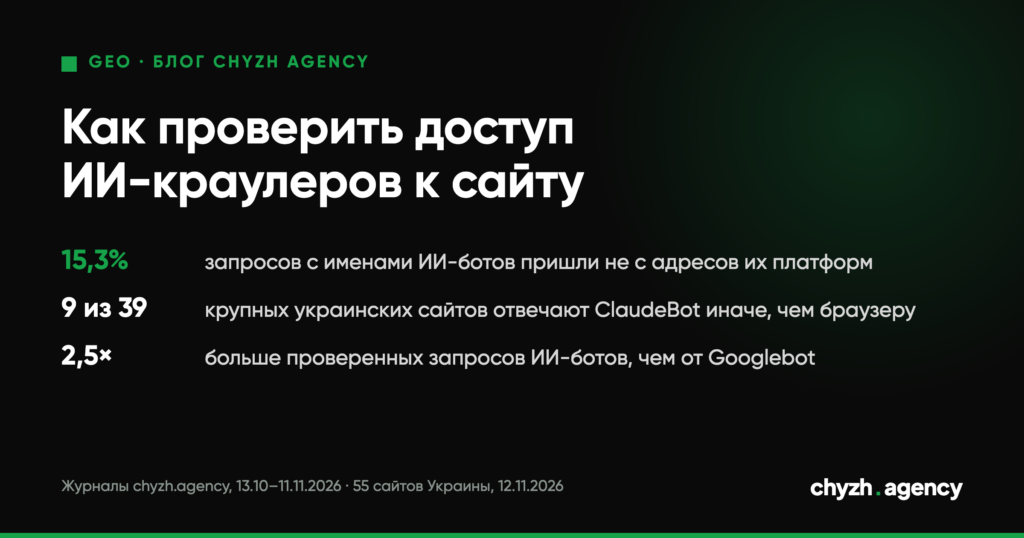
Короткий ответ. Доступ проверяют в четыре слоя: robots.txt для каждого бота отдельно, правила CDN и файрвола, журналы сервера и сверка IP с официальными списками платформ. Одного robots.txt мало. На 9 из 39 крупных украинских сайтов, которые мы проверили 12 ноября 2026 года, файл разрешал ClaudeBot, но сервер на это имя отвечал 403, 429, 503 или не отвечал вовсе.
Кого пускать, зависит от цели. От поисковых ботов и ботов запроса пользователя зависит, сможет ли ИИ-система открыть и процитировать страницу. Боты для обучения касаются прав на текст.
Ниже матрица ботов по платформам, что показали 30 дней журналов нашего сайта chyzh.agency, и шесть шагов проверки.
Три роли ИИ-ботов: обучение, поиск и запрос пользователя
Платформы разделяют ботов по задачам, поэтому каждую роль открывают или закрывают отдельной строкой в robots.txt.
- Обучение. Бот собирает страницы, которые могут попасть в обучение моделей: GPTBot у OpenAI, ClaudeBot у Anthropic, meta-externalagent у Meta. У Google и Apple для этого есть только токены без отдельного бота: Google-Extended и Applebot-Extended.
- Поиск. Бот строит индекс, из которого ИИ-поиск берет источники со ссылками: OAI-SearchBot для ChatGPT, Claude-SearchBot, PerplexityBot. OpenAI пишет прямо: сайты, закрытые для OAI-SearchBot, не появляются в ответах поиска ChatGPT, разве что как навигационные ссылки.
- Запрос пользователя. Бот открывает конкретную страницу, когда о ней спрашивает человек в чате: ChatGPT-User, Claude-User, Perplexity-User. OpenAI и Perplexity предупреждают, что такие запросы могут не выполнять robots.txt. Anthropic пишет, что все три ее бота robots.txt выполняют.
Больше всего путаницы вокруг Google. По документации Google (обновлена 30.10.2026), Google-Extended управляет обучением Gemini и подстановкой данных из индекса в Gemini Apps и Vertex AI (grounding). На появление сайта в Поиске он не влияет. Чтобы попасть ссылкой в AI Overviews или AI Mode, страница должна быть в индексе Поиска и иметь право на сниппет, а управлять этим Google предлагает через правила для Googlebot и директивы nosnippet, max-snippet, noindex. Закрыть Googlebot ради этого значит исчезнуть из Поиска.
Матрица ботов по платформам
Сверено с исходным HTML официальных страниц 12.11.2026, даты обновления в источниках в конце.
| Платформа | Бот | Роль | robots.txt по документации | Проверка IP |
|---|---|---|---|---|
| OpenAI | GPTBot | обучение | выполняет | gptbot.json |
| OpenAI | OAI-SearchBot | поиск ChatGPT | выполняет, изменения подхватывает примерно за 24 ч | searchbot.json |
| OpenAI | ChatGPT-User | запрос пользователя | правила «могут не применяться» | chatgpt-user.json |
| Anthropic | ClaudeBot | обучение | выполняет, поддерживает Crawl-delay | bots.json |
| Anthropic | Claude-SearchBot | поиск Claude | выполняет | тот же список |
| Anthropic | Claude-User | запрос пользователя | выполняет | тот же список |
| Perplexity | PerplexityBot | поиск, по документации без обучения | выполняет, до 24 ч | perplexitybot.json |
| Perplexity | Perplexity-User | запрос пользователя | «обычно игнорирует» | perplexity-user.json |
| Googlebot | Поиск, включая AI Overviews и AI Mode | выполняет | common-crawlers.json, DNS *.googlebot.com | |
| Google-Extended | обучение Gemini и grounding | только токен, отдельного бота нет | не нужна | |
| Google-Agent | агенты Google по запросу пользователя | обычно игнорирует | user-triggered-agents.json | |
| Apple | Applebot | Siri, Spotlight, Safari; данные могут пойти в обучение | выполняет; без своей группы берет правила Googlebot | applebot.json, DNS *.applebot.apple.com |
| Apple | Applebot-Extended | запрет обучения моделей Apple | только токен, сам не сканирует | не нужна |
| Meta | meta-externalagent | обучение и индексация | выполняет | списка нет |
| Meta | meta-webindexer | поиск Meta AI | выполняет | списка нет |
| Meta | meta-externalfetcher | запрос пользователя | может обходить | списка нет |
| Amazon | Amazonbot · Amzn-SearchBot · Amzn-User | сервисы и обучение · поиск Alexa · запрос пользователя | выполняют; Amzn-User может выполнять не все правила | списки на странице Amazon |
| Mistral | MistralAI-Training · MistralAI-Index · MistralAI-User | обучение · поиск в Vibe · запрос пользователя | отдельный токен для каждой роли | списки для Index и User |
| DuckDuckGo | DuckAssistBot | ответы DuckAssist, без обучения | выполняет, изменения за 72 ч | duckassistbot.json |
| Common Crawl | CCBot | открытый архив веба | выполняет | ccbot.json, DNS *.crawl.commoncrawl.org |
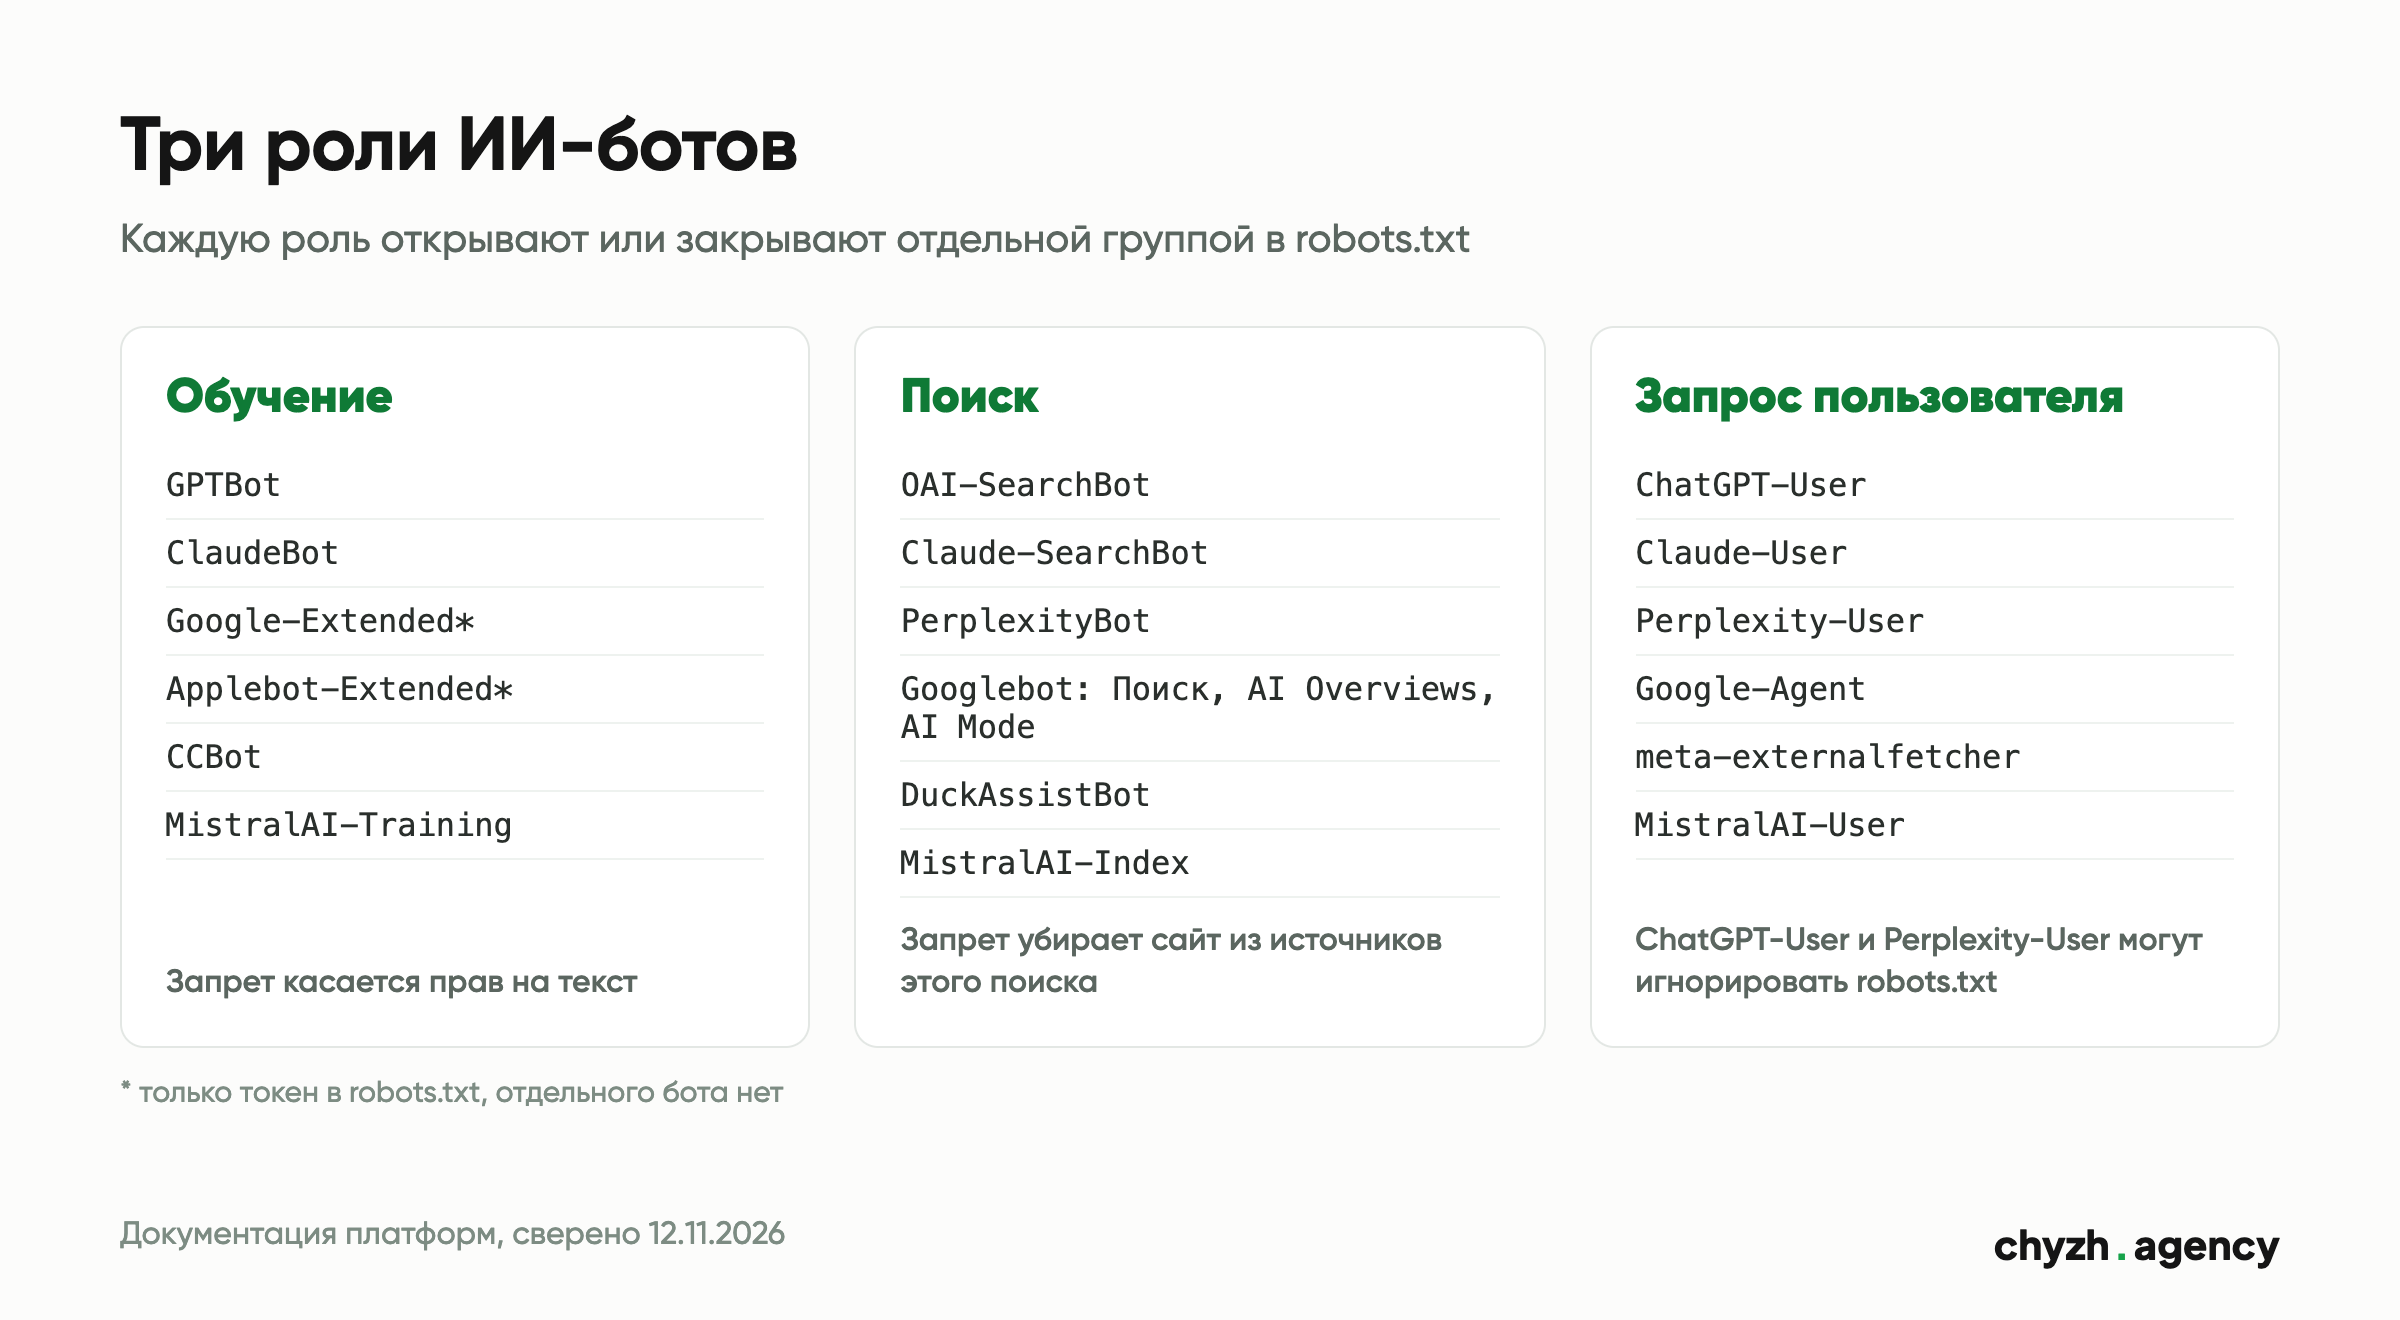
Две детали, на которых часто ошибаются. Первая: группа для конкретного бота и общая группа * не объединяются. Бот, названный в собственной группе, правила из * уже не читает. Вторая: Applebot без собственной группы выполняет правила, написанные для Googlebot.
Что показали 30 дней журналов chyzh.agency
Как считали. Взяли журналы nginx нашего сайта за 13.10–11.11.2026 (время UTC). В нашей конфигурации журнал записывает настоящие адреса клиентов. Каждый запрос с именем бота сверили с официальным списком IP платформы по состоянию на 12.11.2026. Отдельно выделили сканер: адреса, которые за месяц назывались тремя и более разными ИИ-ботами или искали файлы .env, ключи и пароли.
| Бот | Запросов с этим именем | С официальных IP | Сканер под чужим именем | Другие IP вне списка |
|---|---|---|---|---|
| GPTBot | 2 335 | 2 248 | 87 | 0 |
| ClaudeBot | 1 833 | 1 752 | 81 | 0 |
| PerplexityBot | 930 | 833 | 97 | 0 |
| OAI-SearchBot | 371 | 272 | 99 | 0 |
| ChatGPT-User | 337 | 195 | 109 | 33 |
| Claude-User | 184 | 26 | 71 | 87 |
| Claude-SearchBot | 76 | 0 | 76 | 0 |
| Perplexity-User | 67 | 0 | 67 | 0 |
| Googlebot, для сравнения | 2 510 | 2 100 | 177 | 233 |
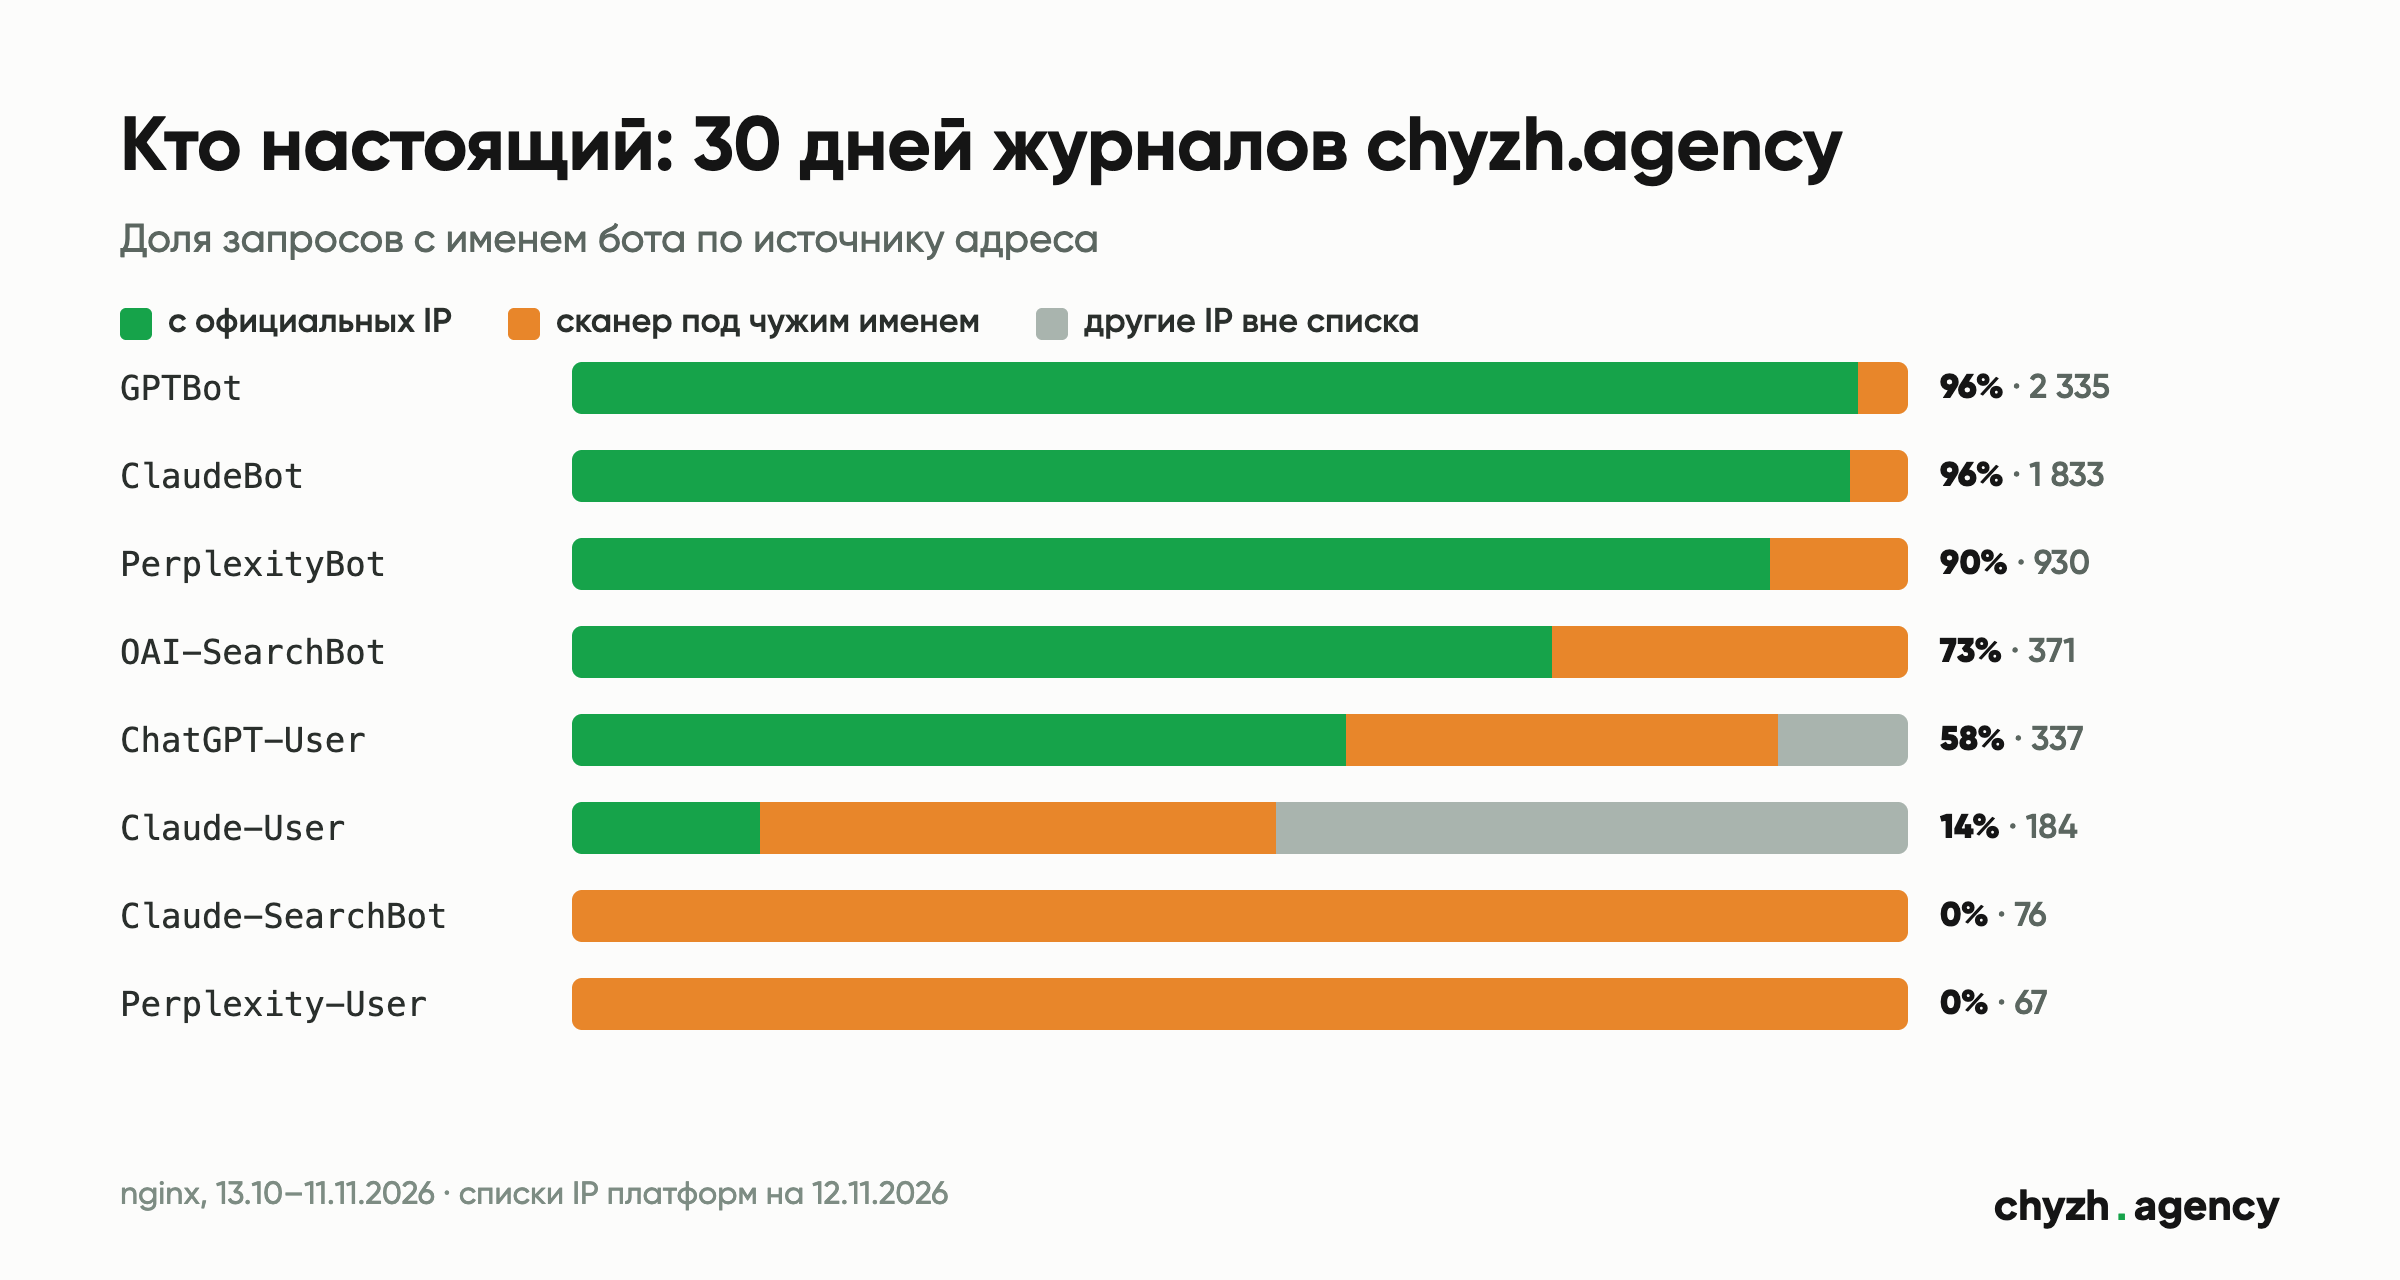
Имена ИИ-ботов использует сканер. Таких адресов 38. Из них 24 по очереди называли себя тремя и более ботами, 34 искали .env, ключи облачных сервисов и SSH. 20 адресов принадлежат Google Cloud, 13 Cloudflare. Claude-SearchBot и Perplexity-User за 30 дней приходили только от сканера, настоящих визитов этих ботов в журнале нет. Всего из 6 301 запроса с именами ботов OpenAI, Anthropic, Perplexity и DuckDuckGo 964 (15,3%) пришли не с адресов этих платформ.
Проверенных запросов от ИИ-ботов больше, чем от Googlebot. Боты OpenAI, Anthropic и Perplexity сделали 5 326 запросов с официальных адресов, Googlebot 2 100, в 2,5 раза меньше. Сколько из этих визитов закончились цитированием, журнал не показывает.
GPTBot читает в основном карты сайта. На sitemap-файлы пришлось 77% его проверенных запросов, на страницы и записи 13%. 901 запрос ушел на /ru/sitemap_index.xml, которой не существует, то есть получил 404. С 16.10 по 06.11 это повторялось примерно 40 раз в сутки. Адрес указывает служебный /ru/robots.txt, который WordPress с Yoast генерирует для языковой версии. На страницах сайта и в главной карте сайта его нет. Ошибку мы нашли именно во время этого разбора и 12.11.2026 исправили: /ru/robots.txt, /ua/robots.txt и карты сайта в языковых каталогах теперь переадресуют (301) на корневые файлы.
Запросы пользователей видны в журнале. ChatGPT-User пришел 195 раз с 164 разных адресов OpenAI, все с ответом 200: главная 86, страницы и записи 80, кейсы 25. Claude-User с адресов из списка Anthropic пришел только 26 раз. Еще 87 запросов с этим именем поступили с адресов вне списка, почти половина этих адресов в Google Cloud. Anthropic ли это с новых адресов или подделка, по нашим данным сказать нельзя.
Читают ли боты robots.txt, из журнала не видно. Типовой шаблон nginx на нашем сервере отключает запись для /robots.txt строкой access_log off. Если хотите видеть, когда боты перечитывают правила, проверьте эту строку в своей конфигурации.
Границы этих данных. Один сайт агентства за 30 дней. Списки IP мы взяли по состоянию на 12.11.2026, а платформы их обновляют: OpenAI обновила список ChatGPT-User 06.11, Perplexity свои 28.10, Anthropic 20.10. Поэтому часть «других IP вне списка» может быть настоящей. У Bytespider и ботов Meta официальных списков IP нет, их мы не сверяли.
Что закрывают крупные украинские сайты
Как считали. 12.11.2026 мы загрузили robots.txt 55 крупных публичных сайтов: 16 интернет-магазинов, 10 маркетплейсов и досок объявлений, 16 медиа, 8 банков, 5 операторов связи и доставки. Файлы разобрали по тем же правилам, что и наш чекер. Затем трижды запросили главную страницу каждого сайта с подписью браузера и с подписями пяти ИИ-ботов.
- 47 файлов прочитались. 8 сайтов вместо robots.txt отдали HTML-страницу с ошибкой, проверкой или заглушкой, 4 из них страницу проверки Cloudflare.
- Ни один из 47 файлов не закрывает весь сайт для GPTBot, ClaudeBot, OAI-SearchBot, PerplexityBot или ChatGPT-User. 5 сайтов закрывают других ботов: Amazonbot (3), CCBot, Bytespider и meta-externalagent (по одному).
- 13 сайтов называют ИИ-ботов поименно. На 4 из них бот получает собственную группу только с
Allow: /и из-за этого не видит от 3 до 47 запретов из группы*: поиска, личного кабинета, корзины. - 33 из 55 сайтов работают через Cloudflare, судя по заголовку Server.
- 16 сайтов ответили 403 или 503 даже на запрос с подписью браузера: файрвол реагирует на наш клиент, сравнивать там нечего. Из остальных 39 сайтов 9 во всех трех прогонах отвечали на имя ИИ-бота иначе, чем браузеру: 403, 429, 503 или тишина. ClaudeBot получил отказ на всех 9, GPTBot и PerplexityBot на 4. Robots.txt на всех 9 этого бота разрешает, на двух даже отдельной группой.
Границы этих данных. Мы подставляли только имя бота со своего адреса. Файрвол может пропускать настоящего ClaudeBot с адресов Anthropic и отсекать тех, кто лишь назвался им, как сканер в наших журналах. Как сайт отвечает настоящим ботам, видно только в его журналах и панели CDN.
Проверка доступа за шесть шагов
-
Прочитайте robots.txt глазами бота. Для каждого нужного бота найдите его группу. Нет группы, действует
*. Есть группа, бот читает только ее. У поддоменов собственные robots.txt. Код ответа тоже важен: при 4xx (кроме 429) Google считает, что ограничений нет, а при 5xx первые 12 часов останавливает сканирование сайта. -
Прогоните домен через чекер. Наш чекер ИИ-краулеров (интерфейс на украинском) разбирает robots.txt для 23 ботов, группирует их по ролям и показывает сработавшую строку. Правил файрвола он не видит, поэтому вердикт звучит как «разрешено robots.txt».
-
Проверьте CDN и файрвол. В Cloudflare это Security → Settings → Bot traffic → AI Crawler and Agent access policies. Для поиска, агентов и обучения отдельно выбирают Block, Block on pages with ads или Allow, а для обучения еще Disallow через robots.txt. Если включен Bot Preference Sync и хотя бы одна политика блокирует, Cloudflare дописывает свои запреты в начало вашего robots.txt. Bot Fight Mode исключениями в WAF не обойти. Типовые значения менялись: в июле 2025 года Cloudflare объявила блокировку ИИ-краулеров по умолчанию, а действующая документация (обновлена 02.11.2026) ставит новым доменам Allow. Смотрите настройки своей зоны.
-
Запросите страницу от имени бота. Сравните код ответа для браузера и для бота:
curl -s -o /dev/null -w "%{http_code}\n" -A "Mozilla/5.0" https://example.com/
curl -s -o /dev/null -w "%{http_code}\n" -A "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; ClaudeBot/1.0; +claudebot@anthropic.com)" https://example.com/
Разные коды означают, что сервер реагирует на имя. Пропустит ли он настоящего бота с его адреса, этот тест не покажет.
-
Посмотрите журналы. Посчитайте запросы и коды ответа по каждому боту, например для ClaudeBot:
grep "ClaudeBot" access.log | awk '{print $9}' | sort | uniq -cОтдельно проверьте, записывает ли сервер вообще запросы к
/robots.txt. -
Сверьте IP. Адреса из журнала сравните со списками из таблицы выше. Google, Apple и Common Crawl дополнительно дают проверку через обратный и прямой DNS, пример из документации Google:
host 66.249.66.1
host crawl-66-249-66-1.googlebot.com
Запросы, которые сверку не прошли, не считайте визитами ботов и не открывайте для них файрвол.
Кого пускать, а кого закрывать
Для сайта услуг или магазина, которому нужны обращения из ИИ-поиска, мы оставляем открытыми поисковых ботов и ботов запроса пользователя. Ботов для обучения закрывают, когда важно, чтобы тексты не попадали в модели, например в медиа с платным доступом. По документации OpenAI, Anthropic, Google и Apple, на появление в их поиске это не влияет.
Появляются и общие сигналы «без обучения». Anthropic с 30.10.2026 начала постепенно учитывать машиночитаемый сигнал по черновику рабочей группы IETF aipref, но правило для ClaudeBot в robots.txt имеет более высокий приоритет. Google планирует поддержать этот сигнал в начале 2027 года.
Открытый доступ цитирования не гарантирует, он лишь дает платформе прочитать страницу. Что проверять дальше, мы описали в статье что такое GEO-аудит. Если страницы нет даже в обычном индексе, начните с разбора почему страница не индексируется.
Следующий шаг
Пройдите шесть шагов для главной и для двух-трех страниц, с которых приходят заявки, и запишите, какие боты до них реально доходят. Если журналы, файрвол и robots.txt показывают разное, начните с файрвола: он отвечает боту раньше, чем тот доберется до robots.txt или страницы. Доступ ботов, журналы и настройки CDN мы проверяем на старте GEO-продвижения.
Автор: Евгений Павленко, DevOps. Проверил: Дмитрий Попрядухин, Head of SEO.
Источники: OpenAI, «Overview of OpenAI Crawlers», даты обновления на странице нет, сверено 12.11.2026; списки IP OpenAI gptbot.json (22.09.2026), searchbot.json (02.01.2026), chatgpt-user.json (06.11.2026); Anthropic, «Does Anthropic crawl data from the web, and how can site owners block the crawler?», обновлено 04.11.2026, список IP bots.json (20.10.2026); Perplexity, «Perplexity Crawlers», обновлено 29.10.2026, списки IP 28.10.2026; Google, «List of Google’s common crawlers», 30.10.2026; «List of Google user-triggered fetchers», 19.08.2026; «Verify requests from Google crawlers and fetchers», 20.03.2026; «AI features and your website», 10.12.2025; «How Google interprets the robots.txt specification», 23.10.2026; Apple, «About Applebot», 04.09.2026; Meta, «Meta Web Crawlers», 21.05.2026; Amazon, «Amazon Web Search crawlers», 26.10.2026; Mistral, «Mistral crawlers», без даты, сверено 12.11.2026; DuckDuckGo, страница о DuckAssistBot, без даты, сверено 12.11.2026; Common Crawl, «CCBot», без даты, список IP 11.08.2026; Cloudflare, «AI Crawler and Agent access policies» и «robots.txt setting», 02.11.2026, «Bot Fight Mode», 03.08.2026, блог «Content Independence Day», 01.07.2025; журналы nginx chyzh.agency за 13.10–11.11.2026; robots.txt и ответы главных страниц 55 украинских сайтов, 12.11.2026; снимок выдачи Google Украина по запросу о проверке доступа ИИ-краулеров к сайту (на украинском), 12.11.2026.
Похожие статьи
Прогнали бесплатные проверки audit.chyzh.agency на своём сайте: баллы от 0 до 100. Что видит автомат,...
Даже ИИ-режим Google путает GEO с локальным SEO. Что входит в GEO-продвижение сайта, какие советы...