
Почему страница не индексируется: проверка без догадок
 Виктория Репетюк
Короткий ответ. Откройте конкретный адрес в инструменте проверки URL в Search Console и идите по порядку: статус и его причина, как Google нашёл страницу, когда последний раз сканировал, разрешено ли индексирование и какой канонический адрес он выбрал. Вопрос качества страницы имеет смысл задавать только тогда, когда все эти пункты в порядке. Количество результатов по запросу site: для такой проверки не подходит: Google прямо пишет, что этот оператор не всегда возвращает все проиндексированные адреса.
Мы прошли этот маршрут для всех 346 адресов из карт сайта chyzh.agency 12 ноября 2026 года. В исходном HTML не нашлось ни одного технического запрета, и всё равно 122 адреса не в индексе.
Почему количество результатов site: не измеряет индекс
Оператор site: удобен, чтобы увидеть, есть ли сайт в поиске вообще. Справка отчёта «Индексирование страниц» даже советует его владельцам сайтов до 500 страниц как первый шаг. Считать им индекс нельзя, и объясняет это сам Google в документации оператора (обновлена 18.12.2025):
- запрос
site:не всегда возвращает все URL, проиндексированные с указанным префиксом; - без поискового слова результаты не ранжируются, и после самого короткого адреса они выбираются «относительно случайно».
Для отдельной страницы Google отсылает к проверке URL. Отчёт об индексировании показывает общую картину, но искать в нём состояние конкретного адреса, по словам самой справки отчёта, нельзя.
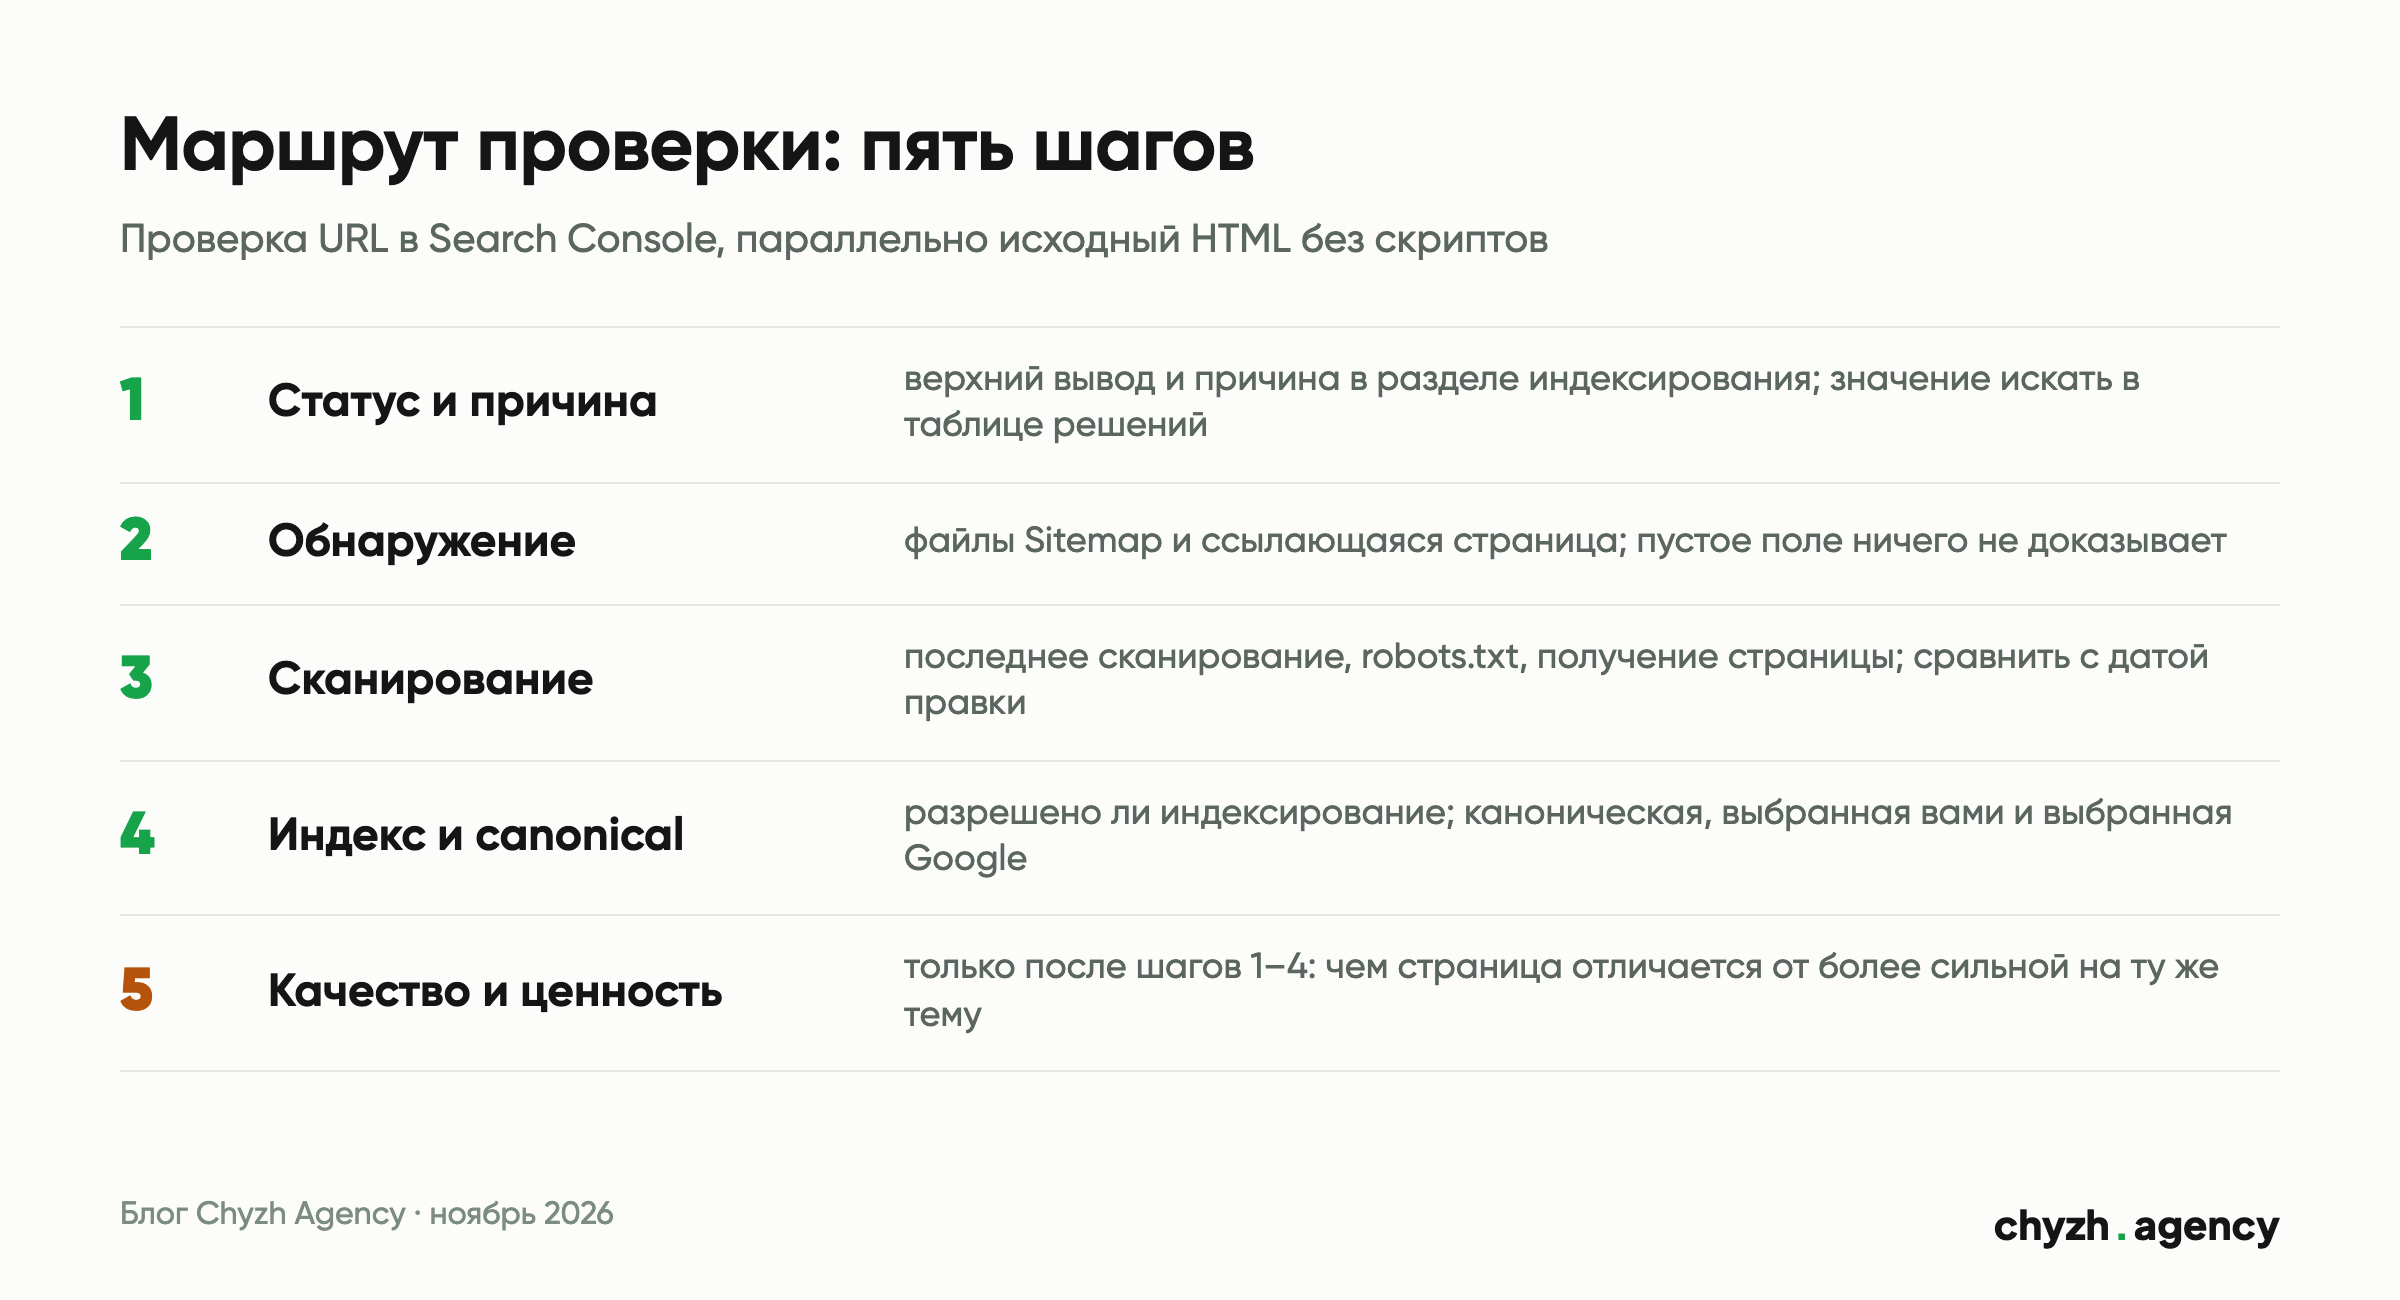
Маршрут проверки: пять шагов
- Статус и причина. Верхний вывод инструмента («URL есть в индексе Google» или «URL нет в индексе Google») говорит, может ли адрес появиться в поиске. Под ним, в разделе об индексировании страницы, указана причина. Её значение ищите в таблице решений ниже.
- Обнаружение. Поля «Файлы Sitemap» и «Ссылающаяся страница». Пустое поле ничего не доказывает: в нашей выборке поле файлов Sitemap пустое для всех 346 адресов, хотя у 224 из них статус «Страница отправлена и проиндексирована». Поэтому внутренние ссылки на страницу считайте сами.
- Сканирование. «Последнее сканирование», «Сканирование разрешено?», «Получение страницы». Всё, что показывает инструмент, относится к версии из последнего сканирования. Если вы что-то исправили позже, Google этого ещё не видел.
- Индексирование и канонический адрес. «Индексирование разрешено?», «Каноническая страница, выбранная пользователем» и «Каноническая страница, выбранная Google». Если они разные, Google считает страницу копией другой. Проверка опубликованной версии копии и канонические адреса не тестирует, это видно только в данных о проиндексированной версии.
- Качество и ценность. Только теперь: на какой вопрос отвечает страница, чем она отличается от более сильной страницы сайта на ту же тему, есть ли в ней то, чего нет в других местах.
Параллельно с шагами 2–4 посмотрите исходный HTML, без выполнения скриптов. Команда curl -sI <адрес> покажет код ответа и заголовок X-Robots-Tag. Команда curl -s <адрес> вместе с поиском по словам robots, canonical, hreflang покажет соответствующие теги в <head>.
Что показала проверка 346 адресов chyzh.agency
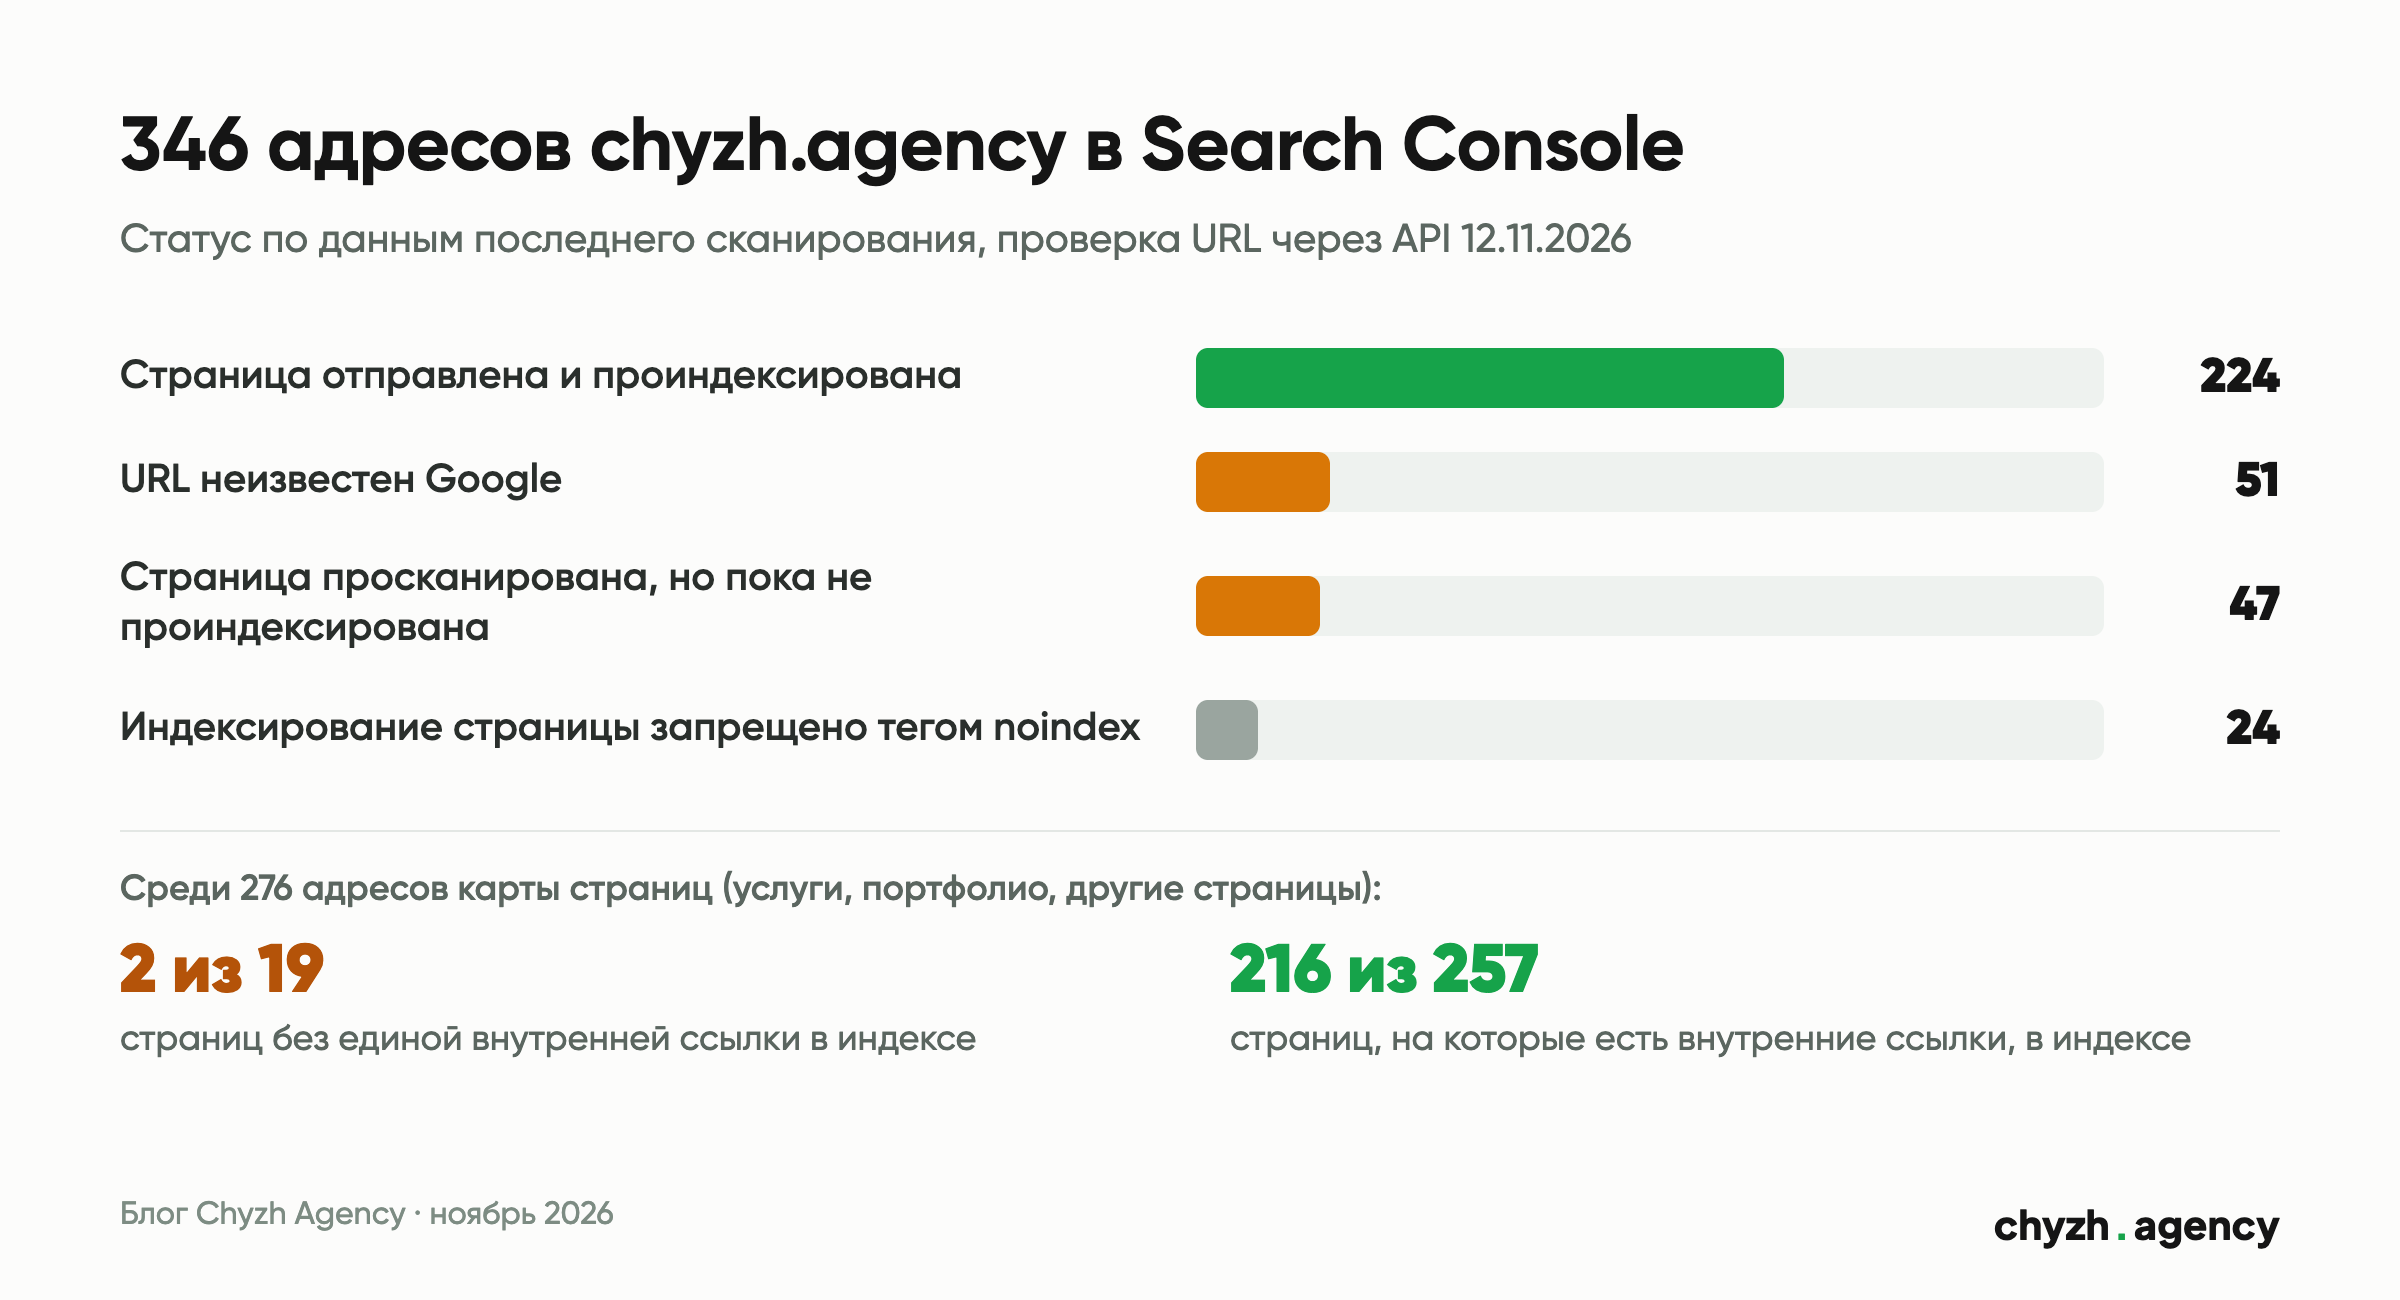
Как считали. 12 ноября 2026 года мы взяли все адреса из четырёх карт сайта: 276 страниц, 24 записи блога, 39 профилей команды, 7 рубрик. Каждый проверили через Search Console API (метод проверки URL), затем в тот же день загрузили исходный HTML и посчитали внутренние ссылки со всех 346 страниц и ещё с 45 страниц списка портфолио. Индексирование не запрашивали и ничего на сайте не меняли.
| Статус в Search Console | Адресов | Что это за страницы |
|---|---|---|
| Страница отправлена и проиндексирована | 224 | большинство услуг, кейсов и записей |
| URL неизвестен Google | 51 | 21 запись блога (15 опубликованы в тот же день, 6 получили новые адреса в ноябре), 14 страниц, 12 профилей, 4 рубрики |
| Страница просканирована, но пока не проиндексирована | 47 | 36 страниц портфолио, 8 других страниц, 3 профиля |
| Индексирование страницы запрещено тегом noindex | 24 | профили команды |
Что из этого следует.
В исходном HTML все 346 адресов отдают 200, имеют index, follow, ни одного заголовка X-Robots-Tag и canonical на самих себя. Техническая проверка страницы в этот день не нашла бы ничего, хотя больше трети адресов не в индексе.
Канонические адреса разошлись только в одном случае из 268, где инструмент показывает оба.
Проблемные адреса Google сканировал давно. Для проиндексированных адресов медиана с последнего сканирования составляет 10,5 дня, для «Страница просканирована, но пока не проиндексирована» 70 дней, для noindex 73 дня.
Ссылки заметно связаны с индексом. Среди 276 адресов из карты страниц у 19 нет ни одной внутренней ссылки, и в индексе из них только 2. Из 257 адресов, на которые ссылки есть, в индексе 216, то есть 84%. Причину эта связь не доказывает: страницы без ссылок у нас в основном старше и менее важны.
Четыре разбора с нашего сайта
Шесть страниц, о которых Google не знает
Страницы таргетированной рекламы и рекламы у блогеров на трёх языках мы опубликовали 30 июля 2026 года. С того дня по 11 ноября, то есть за 104 дня, они не получили ни одного показа. 12 ноября проверка URL для всех шести возвращает «URL неизвестен Google».
Что показал исходный HTML: ответ 200, index, follow, canonical на себя, hreflang на все три языковые версии. Адреса есть в карте страниц. Ни одна из 346 страниц и ни одна страница списка портфолио на них не ссылается, кроме их же языковых версий.
Карта сайта указана в robots.txt. Но отчёт о файлах Sitemap в нашем ресурсе Search Console показывает только одну из четырёх карт, с последней загрузкой 20 марта 2025 года, поэтому подтвердить, что Google прочитал эти адреса из карты, мы не можем.
Исправление: ссылки с близких по теме страниц, например со страницы контекстной рекламы и из раздела услуг; отправить индекс карт сайта в Search Console, чтобы видеть дату чтения; после этого запрос на индексирование для каждой языковой версии. Как эти страницы выглядят на фоне других новых страниц по срокам, мы разбирали в статье о том, когда ждать результатов SEO.
Важная страница, которую Google просканировал и не взял
Украинская страница контекстной рекламы имеет статус «Страница просканирована, но пока не проиндексирована». Последнее сканирование 4 октября. С мая по сентябрь она собрала 116 показов, последний 28 сентября. Средняя позиция по основным запросам была от 47 до 83.
Мы прошли маршрут. Канонический адрес, указанный нами и выбранный Google, один и тот же. На неё ссылаются 115 страниц из карты сайта: 9 из основного текста, остальные из общих блоков шаблона. В основной части страницы около 2 200 слов. Русская и английская версии в индексе, а разные языковые версии Google по документации о нормализации (обновлена 11.09.2026) копиями не считает, если основной текст переведён.
Технические шаги пройдены, остаётся пятый. С 1 октября по 10 ноября показы по запросам со словом «контекстн…» получали русская версия (94 показа) и главная страница на украинском (129 показов, средняя позиция 7). Наша гипотеза: для этих запросов Google считает лучшим ответом главную, и сервисная страница ничем от неё не отличается. Исправление для такого случая: дать странице то, чего нет на главной, например цены, условия и примеры для украинского рынка, и только потом просить повторное индексирование.
Канонический адрес, который Google проигнорировал
Английская рубрика блога SEO при сканировании 2 октября объявляла канонической свою русскую версию. Google выбрал канонической саму рубрику и проиндексировал её. Сегодня в HTML canonical уже указывает на саму страницу.
Здесь сработали два правила Google. Canonical лишь подсказка, и Google может её не принять. А если на сайте есть hreflang, каноническая страница должна быть на том же языке, как сказано в руководстве по указанию канонического адреса (обновлено 10.11.2026). Рубрики у нас работают через многоязычный плагин, поэтому canonical стоит проверять в каждой языковой версии шаблонов рубрик и архивов.
noindex, которого уже нет
24 профиля команды имеют статус «Индексирование страницы запрещено тегом noindex». В исходном HTML 12 ноября у них index, follow. Google последний раз сканировал эти страницы за 26–182 дня до этой проверки, медиана 73 дня.
Вывод для любого сайта: сначала сверьте дату последнего сканирования с датой правки. Если правка новее, статус устарел, и переписывать страницу не нужно. Для важных адресов запустите проверку опубликованной версии, убедитесь, что noindex там нет, и запросите индексирование.
Таблица решений: статус → что проверить первым
Названия статусов даём так, как их показывает русский интерфейс и справка Search Console, в скобках по-английски.
| Статус в Search Console | Что означает | Что проверить первым | Типичное исправление |
|---|---|---|---|
| URL неизвестен Google (URL is unknown to Google) | Google этот адрес ещё не видел | ведёт ли на него хоть одна внутренняя ссылка, есть ли он в карте сайта, новый ли он | ссылки с близких по теме страниц, карта сайта, запрос на индексирование |
| Страница обнаружена, не проиндексирована (Discovered – currently not indexed) | адрес найден, но ещё не просканирован; Google объясняет это переносом сканирования, чтобы не перегрузить сайт | скорость ответа сервера, сколько новых адресов генерирует сайт | убрать лишние адреса из фильтров и параметров, ссылаться на важные страницы |
| Страница просканирована, но пока не проиндексирована (Crawled – currently not indexed) | просканирована, но не взята в индекс; Google пишет, что это часто и не обязательно проблема | canonical, дата сканирования, чем страница отличается от более сильной страницы сайта на ту же тему | сделать страницу отдельным ответом или объединить с другой |
| Индексирование страницы запрещено тегом noindex (Excluded by ‘noindex’ tag) | при сканировании был noindex | исходный HTML и заголовки сейчас, дата последнего сканирования | убрать noindex, проверить опубликованную версию, запросить индексирование |
| Доступ к URL заблокирован в файле robots.txt (URL blocked by robots.txt) | Google не может сканировать страницу | правило в robots.txt | убрать правило; чтобы закрыть от индекса, нужен noindex, robots.txt этого не гарантирует |
| Страница является копией. Канонические версии страницы, выбранные Google и пользователем, не совпадают (Duplicate, Google chose different canonical than user) | Google считает страницу копией другого адреса | выбранная Google каноническая и ваша, обе страницы рядом | правильный canonical на похожую страницу или существенно разное содержание |
| Вариант страницы с тегом canonical (Alternate page with proper canonical tag) | страница правильно указывает на каноническую | ничего | ничего |
| Страница с переадресацией (Page with redirect) | адрес перенаправляет и поэтому не индексируется | в индексе ли конечный адрес | ничего, если перенаправление намеренное |
| Не найдено (404), ошибка сервера (5xx), ложная ошибка 404 | страница не отдаёт содержимое | код ответа и вид страницы при проверке опубликованной версии | 301 на новый адрес, настоящий 404 для удалённых, стабильный сервер |
Когда запрашивать индексирование
Запрос на индексирование помогает, когда причина уже устранена. Исправление он не заменяет. Справка инструмента проверки URL (даты обновления страница не показывает, сверено 12.11.2026) называет три ограничения:
- количество запросов в день ограничено;
- запрос не гарантирует, что страница попадёт в индекс;
- для большого количества новых или обновлённых страниц лучше отправить файл Sitemap с датами
lastmod.
Для статуса «URL неизвестен Google» Google сам советует запросить индексирование и пишет, что обычно это занимает несколько дней. Наши данные добавляют одно: шесть страниц без внутренних ссылок Google не нашёл за 104 дня, поэтому только на запрос мы бы не полагались.
Границы этих данных
- Один сайт, 346 адресов, один день. Сайт небольшой, поэтому на сайтах с тысячами страниц пропорции будут другими.
- Search Console API возвращает состояние версии из последнего сканирования, и для части адресов она давняя.
- Связь между ссылками и индексом мы показываем, но причинность не доказываем.
- Показы, позиции и запросы взяты из Search Console, снимков выдачи для этих цифр мы не использовали.
Следующий шаг
Возьмите пять–десять самых важных страниц и пройдите для них пять шагов выше. Для тех, что не в индексе, найдите строку в таблице решений. Индексация и сканирование стоят первым разделом SEO-аудита, а остальные разделы мы описали в статье что входит в SEO-аудит. Если хотите, чтобы эту работу на вашем сайте сделали мы, подробности на странице SEO-продвижение сайтов.
Автор: Виктория Репетюк, Middle SEO Specialist. Проверил: Дмитрий Попрядухин, Head of SEO.
Источники: Центр Google Поиска, «Как использовать оператор поиска site:», обновлено 18.12.2025 (русская версия); «Что такое нормализация URL», обновлено 11.09.2026 (русская версия); «Как указать канонический URL с помощью атрибута rel=”canonical” и другими способами», обновлено 10.11.2026 (русская версия); справка Search Console «Отчет об индексировании страниц» и «Инструмент проверки URL», даты обновления на страницах не указаны, сверено 12.11.2026; Search Console API, проверка URL для 346 адресов chyzh.agency, 12.11.2026; Search Console, показы и запросы по страницам, 01.05–10.11.2026; отчёт о файлах Sitemap в Search Console chyzh.agency, 12.11.2026; загрузка исходного HTML 346 адресов и 45 страниц списка портфолио, 12.11.2026; снимок выдачи Google Украина по украиноязычному запросу о том, почему страница не индексируется, 12.11.2026.
Похожие статьи
Отчёт от категории до дохода: определения, шаблон и реальный магазин, где органика дала 9,5% покупок,...
Разделите органику по странице входа. В реальном магазине статьи дали 32% органических сессий и ноль...
Дерево решений для фильтров, правила Google о robots.txt и 404, цифры магазина: комбинации фильтров с...